


RAG سازمانی روشی است که دستیار هوشمند پیش از پاسخ، متن مرتبط را از اسناد مجاز همان کاربر پیدا میکند و بر پایهٔ آن، با ارجاع به منبع، جواب میدهد. کیفیتش بیشتر از مدل زبانی، به سند بهروز، سطح دسترسی، پردازش فارسی و سنجش با پرسشهای واقعی بستگی دارد.
بیشتر متنهای فارسی این موضوع یا تعریفاند یا آموزش برنامهنویسی. مدیری که باید تصمیم بگیرد، به پرسشهای دیگری نیاز دارد: چرا دموی خوب بعد از اتصال به اسناد واقعی خراب میشود، چطور مطمئن شویم کارمند سند مدیرعامل را نمیبیند، کیفیت را با چه چیزی بسنجیم و کی اصلاً RAG لازم نیست. این متن کد ندارد و همین پرسشها را جواب میدهد.
RAG سازمانی چه مسئلهای را حل میکند؟
مدل زبانی اسناد شما را نمیشناسد و اگر دربارهٔ آنها بپرسید، ممکن است با اعتمادبهنفس جوابی بسازد. RAG این فاصله را پر میکند: پرسش که میرسد، اول چند قطعهٔ مرتبط از اسناد پیدا میشود و از مدل خواسته میشود فقط بر پایهٔ همان قطعهها پاسخ بنویسد. ایدهٔ پایهاش در مقالهٔ اصلی بازیابی و تولید متن آمده است؛ نسخهٔ سازمانی آن مسئلههای دیگری هم دارد که در آن مقاله نیست.
یک برداشت غلط رایج را همینجا کنار بگذارید: در RAG، مدل با اسناد شما «آموزش» نمیبیند. اسناد هر بار خوانده میشوند. همین باعث میشود سند را بتوان اصلاح یا حذف کرد و پاسخ هم با آن عوض شود. نتیجهٔ عملی برای سازمان اینهاست:
- کارمند تازه جواب رویه را بدون وقتگرفتن از همکار باتجربه پیدا میکند و منبع را هم میبیند.
- کارشناس پشتیبانی پیشنویس پاسخ را از دستورالعمل تأییدشده میگیرد، نه از حافظه.
- پرسش از صدها صفحه قرارداد و آییننامه به پاراگراف مشخص میرسد.
RAG مسئلهٔ سند بد را حل نمیکند؛ آن را سریعتر و با اعتمادبهنفس بیشتر تکرار میکند. بیشتر این متن هم دربارهٔ همین است.
RAG در عمل چطور کار میکند و کجا میشکند؟
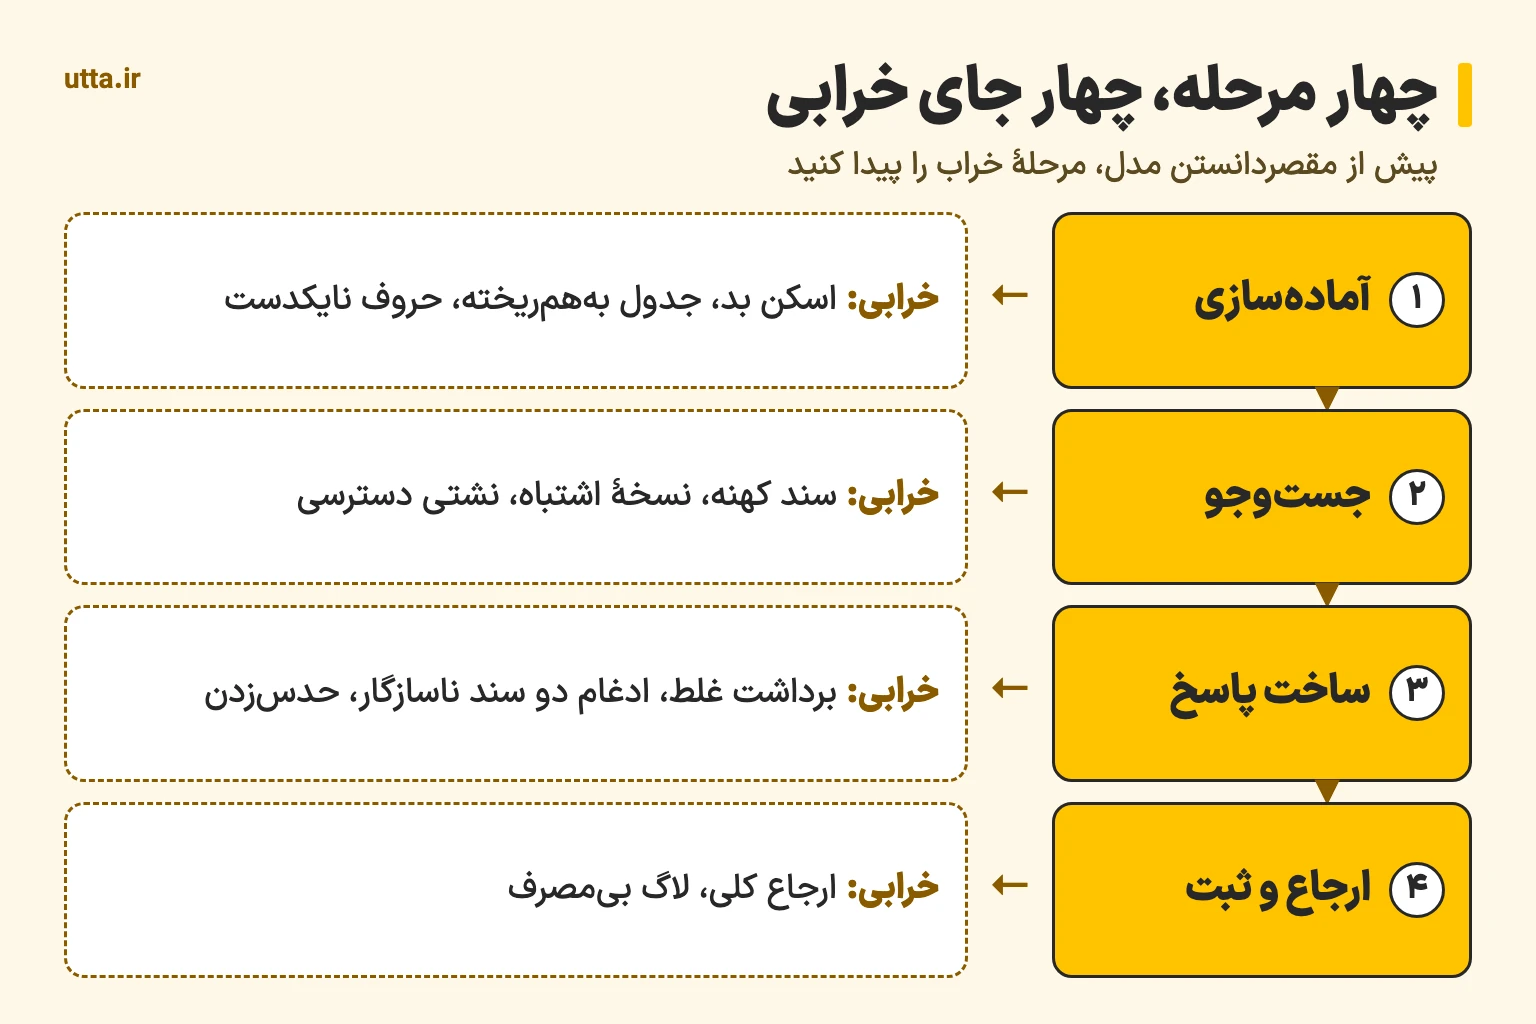
چهار مرحله دارد و هر کدام به شکل خودش خراب میشود. دانستن این چهار مرحله کافی است تا بتوانید از تیم فنی سؤال درست بپرسید:
- آمادهسازی: اسناد خوانده، یکدست و به قطعههای کوچکتر تقسیم میشوند. اسکن بد، جدول بههمریخته و حروف نایکدست اینجا مشکل میسازند.
- جستوجو: بر پایهٔ پرسش، قطعههای مرتبطِ مجاز برای همان کاربر پیدا میشوند. سند کهنه، نسخهٔ اشتباه یا نشتی دسترسی اینجا رخ میدهد.
- ساخت پاسخ: مدل از روی قطعهها متن مینویسد. برداشت غلط، ادغام دو سند ناسازگار و حدسزدن اینجا رخ میدهد.
- ارجاع و ثبت: منبع نمایش داده و گفتوگو ثبت میشود. ارجاع کلی یا لاگ بیمصرف اینجا مانع بررسی میشود.
این تفکیک تجربهٔ خودمان هم هست، گرچه در حوزهٔ دیگری. در منشی تلفنی یوتا، دستیار یک بار به جملهٔ واضح تماسگیرنده جواب نداد. گمان اول کیفیت صدا بود، ولی با رونویسی جداگانهٔ کانال تماسگیرنده معلوم شد علت تنظیم تشخیص گفتار است. همین عادت در RAG هم جواب میدهد: پیش از عوضکردن مدل، ببینید قطعهٔ درست اصلاً به مدل رسیده بود یا نه.
چرا پاسخهای RAG خراب میشوند؟
بیشتر خرابیها از اسناد و بازیابی میآید، نه از هوش مدل. در ادامه خرابیهای رایج با علامت و چارهشان آمده است.
سند کهنه با ظاهر معتبر
آییننامهٔ پارسال هنوز در پوشه است و از نظر متن، حتی شبیهتر به پرسش است. سیستم با خیال راحت از آن جواب میدهد. چاره در رفتار است، نه فقط در فناوری: هر سند صاحب، تاریخ اعتبار و وضعیت داشته باشد و نسخهٔ منسوخ از جستوجو خارج شود، حتی اگر برای بایگانی نگه داشته شود.
تناقض میان اسناد
بخشنامهٔ جدید نیمی از دستورالعمل قدیمی را عوض کرده، ولی متن قدیمی اصلاح نشده است. مدل هر دو را میبیند و ممکن است ترکیبی بسازد که در هیچ سندی نیست. دو کار لازم است: سلسلهمراتب اعتبار را بنویسید که کدام سند بر کدام مقدم است، و از سیستم بخواهید تناقض را نشان دهد، نه اینکه خودش یکی را انتخاب کند. دیدن تناقض خودش خروجی مفیدی است و اغلب نقص واقعی اسناد را رو میکند.
جدولهایی که از هم میپاشند
وقتی جدول قطعهقطعه میشود، عدد از سرستونش جدا میشود و دیگر معلوم نیست «۱۲» نرخ کدام ردیف است. این خرابی خطرناک است، چون پاسخ کاملاً معقول به نظر میرسد. جدول باید با حفظ سرستون پردازش شود. اگر هم پرسش عددی است و داده در سیستمی ساختاریافته وجود دارد، بهتر است مستقیم از همان سیستم خوانده شود، نه از فایل.
PDF اسکنشدهٔ فارسی
نامهٔ مهرخورده، فرم دستنویس و اسکن کج، با تشخیص نوری متن به نوشتهای پر از غلط تبدیل میشوند. نقطهها جابهجا میشوند، ب و پ یا ک و گ قاطی میشوند و عدد غلط خوانده میشود. PDF غیر اسکن هم بیخطر نیست؛ در بعضی فایلها متن فارسی با نویسههای نمایشی یا ترتیب بههمریخته ذخیره شده است.
یک آزمون ساده بدون هیچ ابزار: از چند PDF مهم یک پاراگراف را کپی و در یک فایل متنی ساده بچسبانید، و بعد کلمهای از همان پاراگراف را جستوجو کنید. اگر پیدا نشد یا متن بههمریخته بود، این فایل پیش از ورود به سیستم پردازش جدا میخواهد. برای اسناد حیاتی، بازخوانی انسانی متن استخراجشده هزینهٔ معقولی است.
پرسشی که جوابش در اسناد نیست
خطرناکترین حالت همین است، چون سیستم بدون راهنما ممکن است از دانش عمومی خودش جواب بسازد. رفتار درست گفتن «در اسناد موجود پیدا نشد» و ارجاع به آدم است. این رفتار خودبهخود به وجود نمیآید و باید طراحی و سنجیده شود.
| علامت | علت محتمل | کجا را بررسی کنید |
|---|---|---|
| پاسخ درست ولی منسوخ | نسخهٔ قدیمی در جستوجو مانده | تاریخ اعتبار و صاحب سند |
| پاسخ ترکیبی که در هیچ سندی نیست | تناقض یا قطعههای نامرتبط | سلسلهمراتب اسناد و قطعههای بازیابیشده |
| عدد غلط با متن درست | جدول از هم پاشیده یا تشخیص نوری غلط | متن استخراجشده از همان صفحه |
| «پیدا نشد» برای چیزی که هست | حروف نایکدست یا جستوجوی نامناسب | یکدستسازی فارسی و جستوجوی کلیدواژهای |
| جواب برای پرسش بیربط | نبود قاعدهٔ «نمیدانم» | دستور سیستم و نمونههای آزمون منفی |
سطح دسترسی در RAG سازمانی را چطور درست کنیم؟
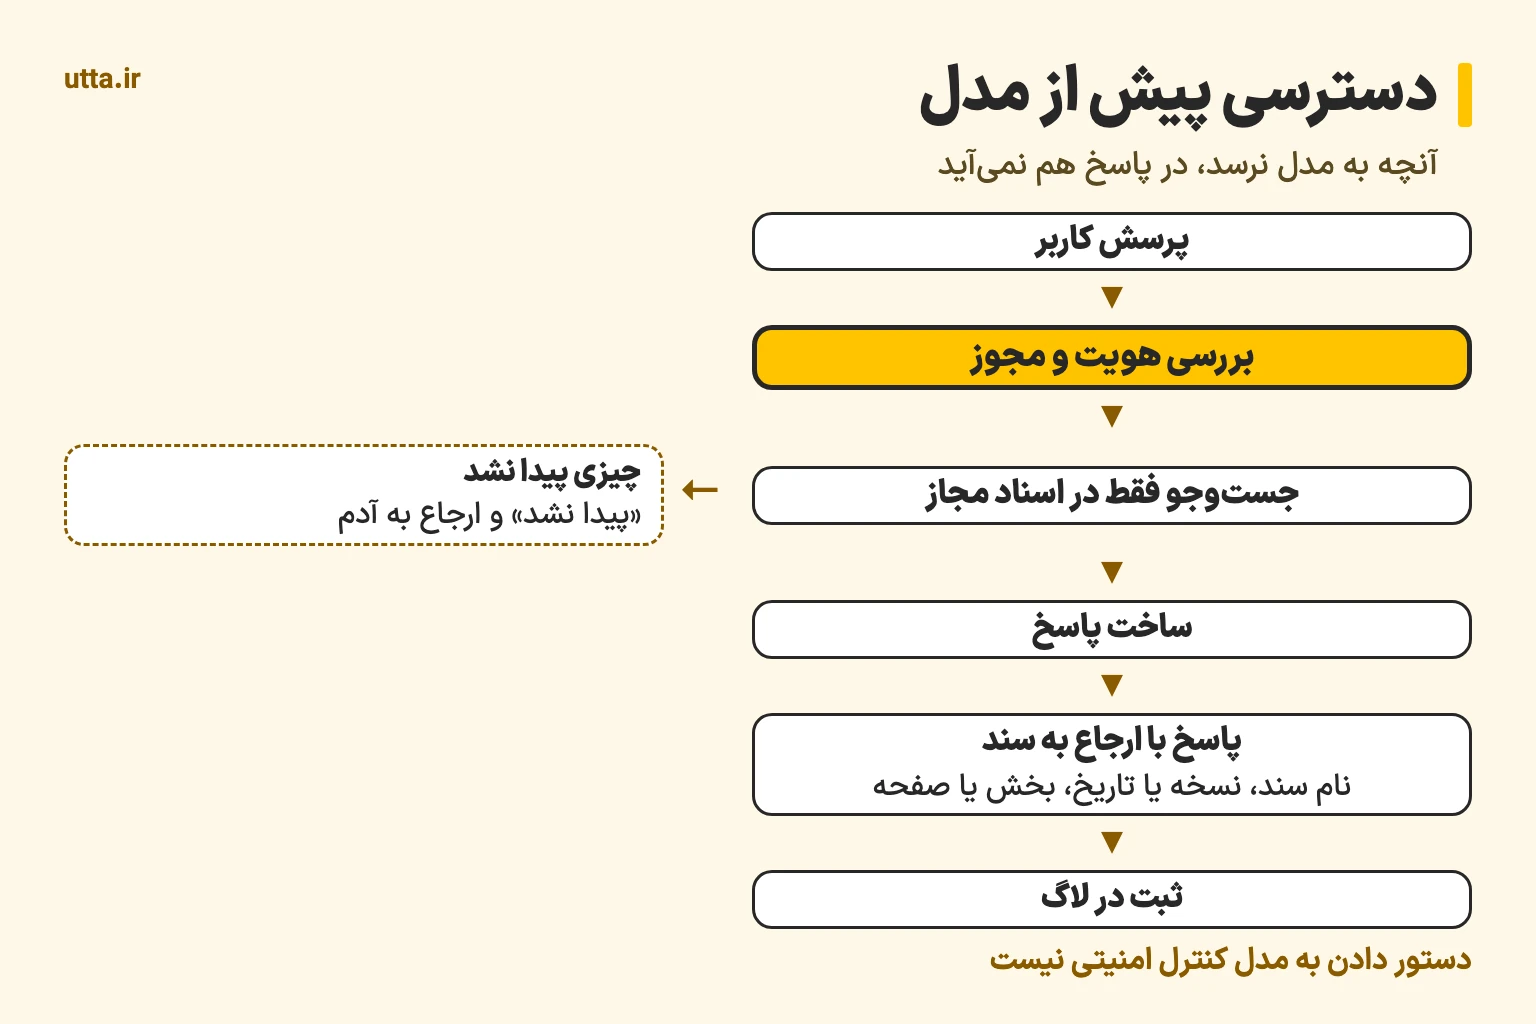
دسترسی باید پیش از رسیدن متن به مدل اعمال شود، نه بعد از ساخت پاسخ. اگر سند محرمانه به مدل برسد و بعد بخواهید پاسخ را فیلتر کنید، دیر شده است؛ خلاصه یا اشارهای از آن ممکن است در جواب بیاید. دستور دادن به مدل که «این را به کارمند نگو» هم کنترل امنیتی نیست.
- دسترسی از منبع بیاید: سیستم باید همان مجوز پوشه یا پنل را رعایت کند، نه فهرست جداگانهای که کمکم از واقعیت فاصله میگیرد.
- تغییر مجوز زود اعمال شود: کارمندی که جابهجا یا جدا شده، نباید هنوز از نمایهٔ قدیمی جواب بگیرد. سند حذفشده هم باید از نمایه پاک شود.
- حافظهٔ موقت جدا باشد: اگر پاسخها برای سرعت ذخیره میشوند، پاسخ یک مدیر نباید به کارمند دیگری برگردد.
- خودِ پرسشها هم حساساند: «تعدیل واحد فروش» در لاگ میتواند خودش خبر باشد. مشخص کنید چه کسی لاگ را میبیند و تا کی نگه داشته میشود.
- اسناد میتوانند دستور پنهان داشته باشند: متن یک فایل یا ایمیل میتواند طوری نوشته شده باشد که رفتار مدل را عوض کند. راهنمای OWASP دربارهٔ تزریق دستور همین را توضیح میدهد و حداقلکردن اختیار سیستم را توصیه میکند. پس اگر دستیار فقط باید بخواند، اجازهٔ اقدام نداشته باشد.
آزمون اصلی ساده است: دو کاربر با سطح دسترسی متفاوت یک پرسش بپرسند و نتیجه را کنار هم بگذارید. بعد مستقیم محتوای سند محرمانه را بپرسید، و دوباره با پرسش غیرمستقیم امتحان کنید. این را در هر دمو از فروشنده بخواهید.
ارجاع به منبع چرا مهم است و چطور باید باشد؟
ارجاع چیزی است که پاسخ را قابلبررسی میکند و کاربر را از باور کور بیرون میآورد. ولی همهچیز به شکل آن بستگی دارد. نوشتن نام پوشه در پایان پاسخ ارجاع نیست. ارجاع خوب این چهار جزء را دارد:
- نام سند و نسخه یا تاریخ اعتبار آن؛
- بخش یا صفحهٔ مشخص، نه کل فایل؛
- لینکی که با یک کلیک همانجا را باز کند، آن هم با رعایت دسترسی؛
- پیوند روشن هر ادعای مهم با منبع خودش.
نکتهای که کمتر گفته میشود: وجود ارجاع یعنی درستی پاسخ نیست. مدل ممکن است سند درستی را نشان دهد و از آن برداشت غلط کند. پس در سنجش دورهای، چند پاسخ را با خود منبع مقایسه کنید. برای پرسشهای حساس هم قاعده بگذارید: بدون منبع، پاسخ نه.
کیفیت RAG را با چه پرسشهایی بسنجیم؟
با پرسشهای واقعی همکارانتان، نه با پرسشهایی که از روی سند ساخته شدهاند. پرسش ساختگی همان کلمات سند را دارد و نتیجهٔ بهتر از واقع میدهد. تیکتها، پیامهای داخلی و سؤالهایی که کارمند تازه میپرسد منبع خوبیاند. مجموعهٔ آزمون باید این پنج دسته را داشته باشد:
| دسته | نمونه | پاسخ قبولشدنی | چه چیزی را میسنجد |
|---|---|---|---|
| جواب در یک سند | «سقف مرخصی استحقاقی چقدر است؟» | پاسخ درست با منبع درست | بازیابی و ارجاع |
| جواب در چند سند یا عددی | «نرخ ردیف فلان جدول بعد از بخشنامهٔ جدید چیست؟» | عدد درست از نسخهٔ معتبر | جدول و نسخه |
| بدون جواب در اسناد | پرسشی که واقعاً سندی ندارد | «پیدا نشد» و ارجاع به آدم | نساختن جواب |
| تناقضدار | موضوعی که دو سند متفاوت گفتهاند | نشاندادن تناقض یا سند مقدم | سلسلهمراتب اعتبار |
| خارج از دسترسی | پرسش کارمند از سند محرمانه | نه محتوا، نه اشاره به آن | سطح دسترسی |
برای هر پرسش، صاحب همان حوزه پاسخ مرجع را مینویسد؛ فروشنده خودش نمره نمیدهد. نتیجه را برای هر دسته جدا گزارش کنید، چون معدل کلی میتواند ضعف بزرگی را پنهان کند. آستانهٔ قبولی را هم با توجه به هزینهٔ خطای حوزهٔ خودتان پیش از اجرا بنویسید. فقط یک مورد آستانه ندارد: نشتی دسترسی باید صفر باشد و هر مورد آن متوقفکننده است.
این مجموعه را بعد از هر تغییر مهم دوباره اجرا کنید: اضافهشدن اسناد تازه، تغییر تنظیمات قطعهبندی، یا عوضشدن مدل. کلیات این روش سنجش و دروازههای پایلوت در راهنمای پیادهسازی هوش مصنوعی در سازمان آمده است.
چه زمانی RAG لازم نیست؟
این بخش برای فروش خوب نیست، ولی چند حالت واقعاً به RAG نیاز ندارند:
- دانش کوچک و پایدار: اگر چند ده پرسش و پاسخ ثابت دارید، با یک فهرست تأییدشده حل میشود. برای مرزبندی، فرق پاسخگوی هوشمند با چتبات را بخوانید.
- پرسش در اصل پرسوجوی داده است: «فروش ماه قبل چقدر بود؟» باید از دیتابیس خوانده شود. پاسخ از فایل گزارش، کند و خطاپذیر است.
- جستوجوی دقیق کافی است: برای شمارهٔ قرارداد، کد کالا یا نام فرد، یک جستوجوی خوب اغلب از دستیار گفتوگویی بهتر است.
- اسناد صاحب ندارند: اگر کسی مسئول بهروزبودن نیست، اول این را حل کنید. وگرنه پروژه خیلی زود بیاعتبار میشود.
- مراجعه کم است: اگر هر سند ماهی یکی دو بار نیاز میشود، هزینهٔ آمادهسازی و نگهداری برنمیگردد. لایههای این هزینه را در آناتومی هزینهٔ ساخت ایجنت جدا کردهایم.
- تصمیم حساس لازم است: RAG میتواند سند را پیدا کند و پیشنویس بدهد. نظر حقوقی یا پزشکی نهایی کار آدم است.
فارسی چه مشکلات خاصی برای RAG دارد؟
متن فارسی یک لایهٔ آمادهسازی اضافه میخواهد که نمونههای انگلیسی آن را نشان نمیدهند. همان یکدستسازی باید هم روی اسناد و هم روی پرسش کاربر اجرا شود. نسخهٔ اصلی سند را هم برای نمایش ارجاع نگه دارید.
| موضوع | نمونه | اگر رسیدگی نشود | راه کار |
|---|---|---|---|
| ی و ک عربی | «كارمند» و «کارمند»، «مدير» و «مدیر» | جستوجوی کلیدواژهای سند را پیدا نمیکند | یکدستسازی پیش از نمایهسازی و جستوجو |
| نیمفاصله | «میشود»، «میشود»، «می شود» | یک واژه چند شکل پیدا میکند | یکدستکردن هر سه شکل |
| اعداد | یک سال یا شمارهٔ بخشنامه با ارقام فارسی، عربی یا لاتین | شمارهٔ بخشنامه و سال پیدا نمیشود | تبدیل به یک شکل در نمایه و پرسش |
| تاریخ | شمسی، میلادی، «پارسال» | نسخهٔ اشتباه انتخاب میشود | ذخیرهٔ تاریخ اعتبار بهصورت ساختاریافته |
| املاهای رایج | «مسئله» و «مسأله»، «رئیس» و «رییس» | نتیجهها ناقص میماند | فهرست معادلهای املایی |
| محاوره و رسمی | «مرخصی چند روزه؟» و «مرخصی استحقاقی» | پرسش با زبان سند نمیخواند | جستوجوی معنایی و واژهنامهٔ سازمان |
| فارسی و لاتین | VPN و «ویپیان» | یکی از دو شکل نتیجه نمیدهد | افزودن هر دو شکل به واژهنامه |
| نام و کد | کد کالا، نام پیمانکار | جستوجوی معنایی کد دقیق را از دست میدهد | ترکیب جستوجوی کلیدواژهای و معنایی |
فهرست را به فروشنده بدهید و بخواهید هر ردیف را با سند واقعی شما نشان بدهد. این آزمون چند دقیقه طول میکشد و زود نشان میدهد فارسی برای او جدی بوده یا نه.
یوتا دربارهٔ RAG چه شاهدی دارد و چه تعهدی میدهد؟
صادقانه بگوییم: کیس مشتری هوش مصنوعی با نام نداریم که اینجا نشان بدهیم. آنچه داریم این است: مهدی بشیرپور، مدیرعامل یوتا، با حدود ۱۸ سال سابقهٔ توسعهٔ نرمافزار روی مدلهای زبانی، RAG و ایجنت متمرکز است. سرویسهای هوش مصنوعی پنل خودمان، مثل امتیازدهی سرنخ و پیشنویس پاسخ تیکت، داخلیاند، و دستیار یوتا روی همین سایت زنده است. میتوانید با دستیار سایت حرف بزنید و ببینید وقتی جواب را نمیداند چه میکند.
دربارهٔ داده هم تعهد ما این است: اطلاعات شخصی پیش از پردازش حذف یا پوشیده میشود، دادهٔ کاری برای آموزش هیچ مدلی نیست، و مسیر پردازش در قرارداد نوشته میشود. برای دادهٔ حساس، مسیر پردازش داخل ایران با کیفیت پایینتر هم هست. میزبانی روی سرور خود سازمان موضوعی است که در نیازسنجی باید بررسی شود و پیش از آن قولش را نمیدهیم. در قطعی اینترنت بینالملل هم درخواست در صف میماند و با پیامک اطلاع داده میشود.
سؤالات متداول
فرق RAG با آموزش مدل روی داده چیست؟
در RAG مدل تغییری نمیکند و هنگام هر پرسش، قطعههای مرتبط اسناد را میخواند. پس با اصلاح سند، پاسخ هم عوض میشود و میتوان منبع را نشان داد. برای بیشتر پرسشهای سازمانی از روی اسناد، این روش از آموزش مدل مناسبتر است.
چطور بفهمیم دموی RAG واقعی است؟
بدترین اسناد خودتان را بدهید: اسکن کج، جدول، دو نسخهٔ متناقض. بعد پرسش محاورهای، پرسش بدون جواب و پرسش خارج از دسترسی بپرسید. دمویی که فقط با فایل تمیز فروشنده اجرا میشود چیز زیادی نشان نمیدهد.
چتبات سازمانی همان RAG است؟
نه لزوماً. چتبات شکل گفتوگو با کاربر است و RAG روش تأمین پاسخ از اسناد. چتبات میتواند با فهرست پرسش و پاسخ ثابت کار کند، و RAG هم میتواند پشت جستوجوی داخلی یا دستیار کارشناس باشد.
اگر مدل زبانی عوض شود، RAG خراب میشود؟
اسناد و نمایه میتوانند بمانند، مگر اینکه روش نمایهسازی هم عوض شود. ولی رفتار پاسخ ممکن است تغییر کند. برای همین مجموعهٔ آزمون باید مال شما باشد و بعد از هر تغییر دوباره اجرا شود.
نگهداری RAG سازمانی با چه کسی است؟
کار فنی با تیم اجراست، ولی بهروزبودن سند با صاحب همان حوزه است. اگر سازمان برای اسناد صاحب تعیین نکند، هیچ پیمانکاری نمیتواند کیفیت پاسخ را حفظ کند. این مسئولیت را پیش از شروع مشخص کنید.
قدم بعدی
چند سند واقعی را، ترجیحاً بدترینهایشان، با چند پرسش واقعی همکارانتان کنار هم بگذارید. اگر میخواهید پرسنل از روی اسناد و سیستمهای داخلی جواب بگیرند، صفحهٔ دستیار هوشمند سازمانی و اگر کانال اصلیتان گفتوگوست، چتبات سازمانی را ببینید. برای جلسهٔ نیازسنجی با شمارهٔ ۰۴۱-۳۳۳۵۴۴۴۰ تماس بگیرید.


ارسال دیدگاه